01Poudy데이터 파이프라인 / 2026.08 – 현재
LLM 판단과 코드 검증을 분리한 3계층 성분 데이터 파이프라인 구축
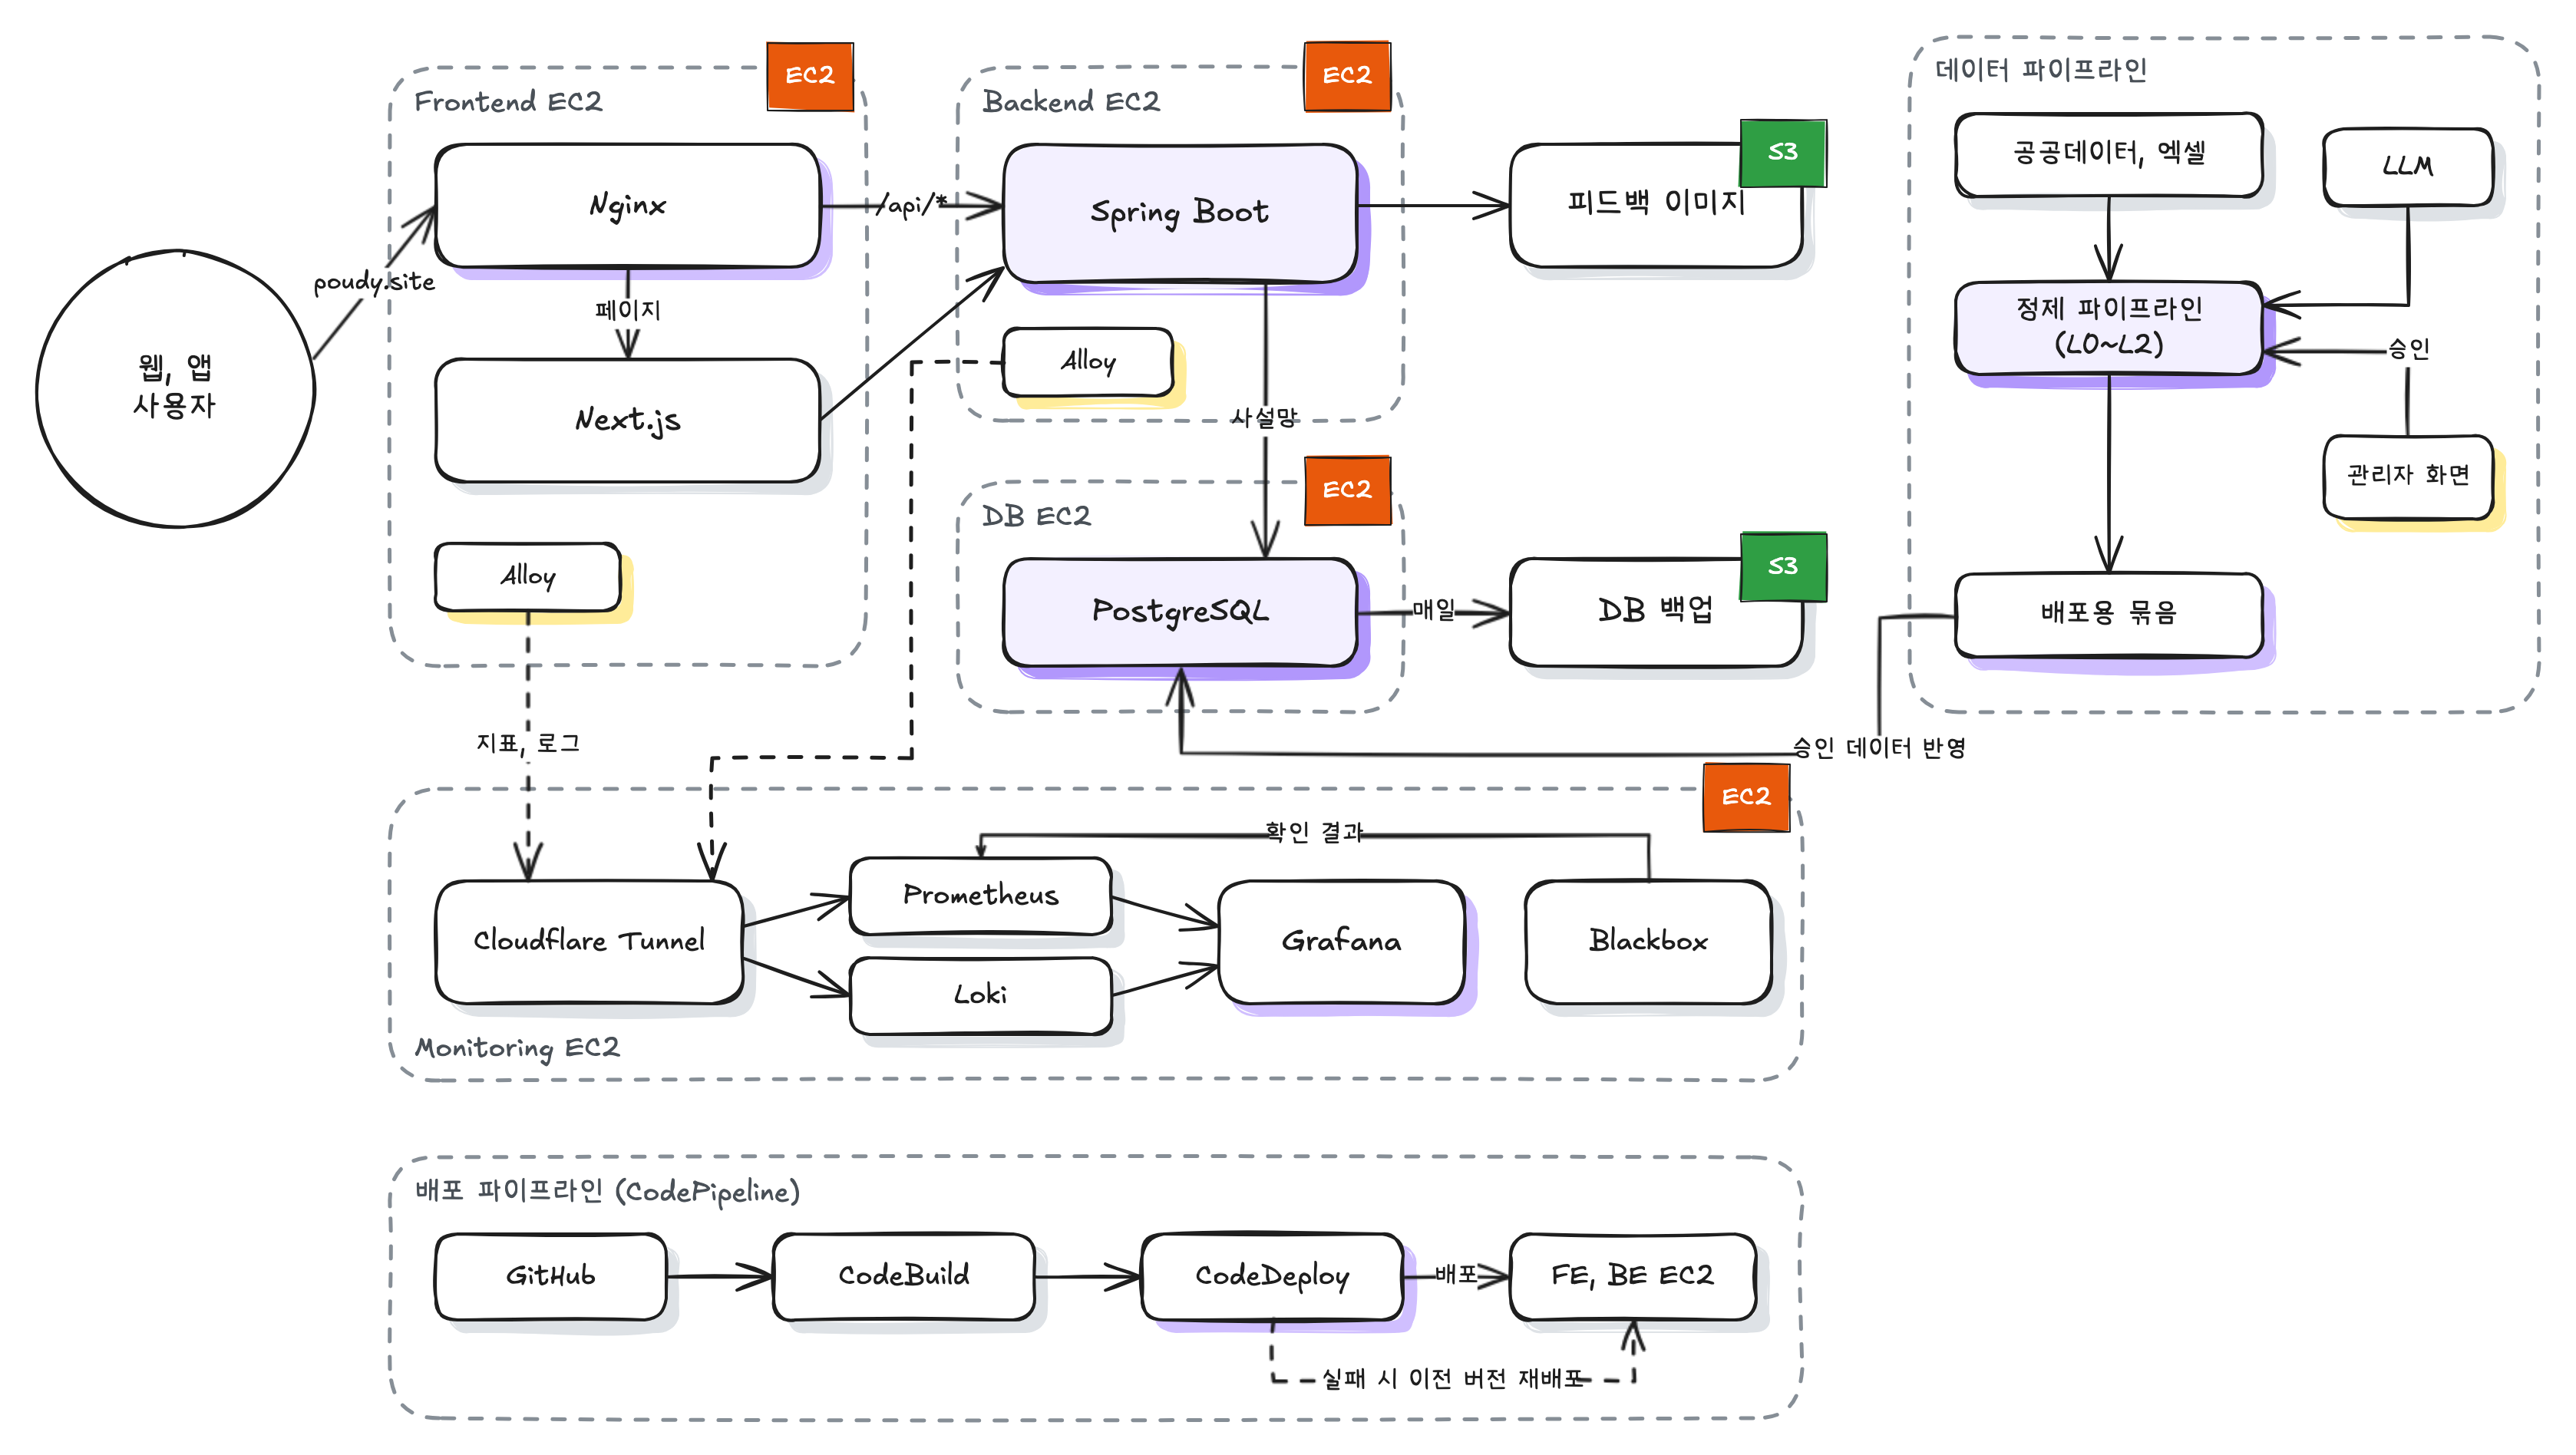
성분 데이터를 처리 단계별 3계층(L0 원본 보관, L1 정리와 검토, L2 승인 데이터)으로 나누고, 답이 정해진 검증은 코드가, 판단이 필요한 작업만 LLM이 맡도록 역할을 나눴습니다.
데이터 3계층 구조와 LangGraph 검증 흐름
크게 보기 ↗
문제 원인
- 원료 한 건의 수집, 가공, 검증과 작업 조율까지 Codex 모델 하나에 맡겨, 3일 동안 Pro 사용 한도를 초기화 3번까지 모두 쓰고도(기본 한도의 4배) 서비스에 쓸 만한 데이터를 얻지 못했습니다.
- 처리와 검증 역할이 나뉘지 않아, 사람이 개입하지 못하는 동안 실패하는 데이터 하나에 걸리면 LLM이 같은 시도를 반복하며 다음 데이터로 넘어가지 못한 채 시간과 토큰만 썼습니다.
- 원본과 가공 결과가 섞여 값의 출처와 승인 근거를 추적하기 어려웠습니다.
해결 과정
- 한 건씩이 아니라 전체 데이터를 배치로 처리하도록 수집 파이프라인을 다시 설계하고, 원본, 정리와 검토 후보, 승인 데이터로 나눈 메달리온 구조(L0~L2)를 적용했습니다.
- 파일 처리, 형식 정리, 중복 검사처럼 규칙이 명확한 일은 Python 코드가, 근거 찾기, 설명 쓰기, 검토처럼 판단이 필요한 일만 LLM이 맡도록 나눴습니다.
- LLM 단계는 LangGraph로 찾기, 고르기, 쓰기, 검토로 나누고, 결과는 코드로 된 정책 게이트를 통과해야 반영되게 했습니다. 근거가 없거나 확신도가 낮은 제안은 자동 반영하지 않고 관리자 검수로 처리합니다.
- 작업 상태와 호출 기록을 저장해 성공한 호출은 재사용하도록 설계했습니다. 시간 초과처럼 일시적인 실패는 재시도하고, 다시 해도 같은 결과가 나오는 실패는 사유를 기록해 DLQ처럼 별도 경로로 빼 두어, 에이전트가 멈추지 않고 다음 원료를 이어서 처리하도록 설계했습니다.
결과
- 원료 22,013건을 같은 규칙으로 처리하는 배치 파이프라인 구축
- 출처와 승인 이력을 남겨 값이 어디서 왔는지 추적 가능
- 성공한 호출은 재사용하고 막히는 데이터는 따로 빼 두어, 한 건에 걸려 토큰만 쓰며 멈추던 문제 해소
- 원료 100건 시험 실행까지 마쳤고, 나머지 원료는 같은 구조로 처리할 예정입니다